 PrintGuard-AI
도움말 · 평가 측정표
기능마다 왜 그 방법을 골랐는지, 무엇을 재서 그렇게 정했는지, 그래서 어떤 한계를 안고 읽어야 하는지 적었습니다. 질문을 누르면 답이 펼쳐집니다. 숫자는 모두 이 저장소의 평가 스크립트로 직접 잰 값입니다. 재지 않은 것은 ‘재지 않았다’고 적었습니다. 측정표 전체는이 페이지 아래쪽에 이어집니다.
검사·검색
가이드 검색에 왜 LLM이 아니라 임베딩 모델을 썼나요?
왜인쇄 가이드는 틀리면 비용이 드는 정보입니다(도련 3mm, 잉크량 한도 같은 값). LLM이 문장을 새로 만들면 그럴듯하지만 틀린 값이 섞일 수 있어서, 답을 만들지 않고 가이드 원문 절을 찾아 그대로 보여 주는 쪽을 택했습니다. 대신 사용자가 가이드와 다른 단어로 물어도 찾아야 하니 단어 일치만으로는 부족했습니다.
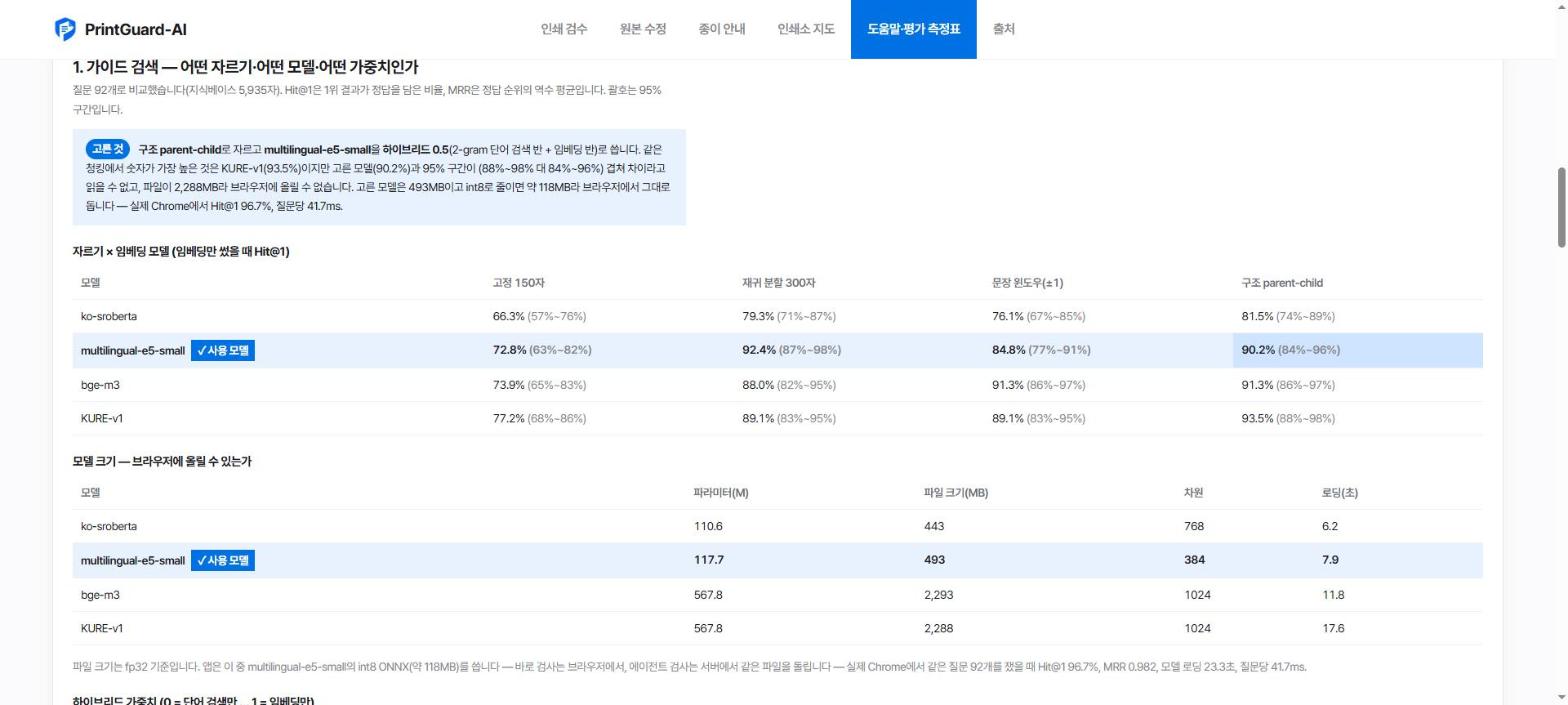
어떻게자르기(청킹) 4종 × 임베딩 모델 4종을 질문 92개로 비교하고 임베딩(dense)과 단어 검색(2-gram BM25)을 각각 z-정규화해0.5 : 0.5로 섞었습니다. 브라우저에서 돌리려고 multilingual-e5-small의 int8 ONNX(약 118MB)를 씁니다.
결과섞어 쓰기(하이브리드)가 MRR@10 0.98 수준으로 가장 좋았습니다. 2.3GB짜리 큰 모델(bge-m3·KURE-v1)과의 차이는 95% 구간이 겹쳐 구분되지 않았습니다. 그래서브라우저에 올릴 수 있는 작은 모델로 정했습니다.
인쇄 색 차이(ΔE)는 어떻게 계산하나요? 실제 인쇄와 같나요?
왜화면의 RGB는 인쇄 CMYK보다 넓은 색을 표현합니다. 어떤 색이 인쇄에서 얼마나 달라질지 찍기 전에 보여 주려면 변환을 직접 계산해야 합니다.
어떻게PDF 안 이미지 픽셀을 sRGB로 봅니다. 그다음 종이에 맞는 CMYK ICC 프로파일로 변환(LittleCMS wasm)한 뒤 다시 Lab으로 읽어 원본과 ΔE2000을 잽니다. 이미지가 인쇄 면적에서 차지하는 비율로 가중해 문서 전체 값도 냅니다. 종이 등급별 공개 프로파일 12개(ECI·ICC 레지스트리)를 씁니다.
결과같은 계산을 Python(Pillow의 LittleCMS)에서 따로 돌려 대조했고 값이 일치했습니다. 공개 테스트 사진 8장으로는 종이별 차이를 쟀습니다 (코팅지 평균 ΔE 4.48, 비코팅지 9.71, 판지 2.79 — 종이 색을 포함한 절대 비색 기준).
종이가 489종인데 프로파일은 12개뿐입니다. 브랜드 종이는 어떻게 하나요?
왜브랜드 종이를 직접 측정한 공개 프로파일이 없습니다. 없는 데이터를 있는 것처럼 쓰지 않으려고, 같은 등급의 공개 프로파일로 근사하고 근사했다고 화면에 표시합니다.
어떻게분광측색기로 잰 종이 흰색(Lab)을 입력하면, 프로파일이 가정한 종이 흰색에서 그 종이로 인쇄 색을 옮겨 ΔE를 다시 잽니다. 보정식은 측정 프로파일 12쌍을 비교해 골랐습니다(선형 방식이 9쌍에서 가장 좋음).
결과검증 스크립트에서 종이 흰색은 입력한 측정값으로 정확히 옮겨졌습니다. 가장 진한 색은 ΔE 0.1 안에서 그대로 남았습니다.
인쇄 불량 점검은 AI 모델인가요?
왜아닙니다. 학습하려면 “이 PDF를 이 종이에 찍었더니 이런 불량이 났다”는 정답 데이터가 필요합니다. 그런데 공개 데이터셋을 찾지 못했습니다 (검색에 걸린 것은 3D 프린팅·PCB·직물 결함이었고 인쇄 결함 논문은 데이터를 공개하지 않았습니다).
어떻게데이터가 없으니 근거 원문을 직접 확인한 점수표로 만들었습니다. 뒷묻음과 눌림, 색판 어긋남, 농도 얼룩이 점수 대상입니다. 점수는 PDF에서 읽은 값(최대 잉크량, 이미지 면적)과 사용자가 고른 종이·평량·후가공으로 매기고 이유마다 출처를 붙입니다.
결과원문과 대조하면서 근거가 틀린 규칙을 뺐습니다(예: ‘제본+코팅지’ 가점 — 원문은 오히려 코팅이 갈라짐을 줄인다고 했습니다). 줄무늬는 인쇄기 쪽 원인이라 예측하지 않습니다. 후가공은 PDF에 정보가 없어서 모를 때는 ‘판단 불가’로 둡니다.
교정 — 왜 기본은 규칙이고 LLM은 선택인가
오탈자 교정에 어떤 방법을 쓰고, 왜 그렇게 정했나요?
왜맞춤법 교정은 틀린 지적 하나가 신뢰를 깎습니다. 그래서 많이 찾는 쪽(재현율)보다 지적이 맞는 쪽(정밀도)을 먼저 봤고 원고를 자동으로 고치지 않고 제안만 합니다.
결과두 검사 방식이 같은 사전을 봅니다. 오용·외래어 표기 사전은 public/data/korean-misuse.json 하나이고, 브라우저의 ‘바로 검사’와 교정 에이전트가 그 파일을 함께 읽습니다. 한쪽에만 낱말을 더하면 두 방식의 결과가 갈립니다.
결과검사 방식에 따라 얹히는 것이 다릅니다. 에이전트 검사에서는 여기에 Kiwi 오타 모델이 더해지고, 키를 넣으면 LLM 교정까지 붙습니다.
어떻게정답을 아는 평가셋을 만들어 비교했습니다 — 가이드 문단을 묶은 문서 60개에 오류 360개를 일부러 넣고 (사전에 있는 오용/없는 오용/무작위 오타/띄어쓰기/율·률), 규칙·Kiwi 형태소 모델·LLM의 조합 7가지를 쟀습니다. 지표는 오류 단위 재현율과 제안 단위 정밀도, 괄호는 문서 단위 부트스트랩 95% 구간입니다.
LLM 모델은 왜 하필 그걸 쓰나요?
왜교정은 문서마다 한 번 부르는 작업이라 무료 등급으로 끝까지 돌 수 있는지가 중요했습니다. 품질이 가장 높은 모델이 목표가 아니었습니다.
어떻게무료 등급이 있는 Flash-Lite 계열을 기본값으로 두고 모델 이름은PG_LLM_MODEL로 바꿀 수 있게 했습니다.
결과처음 적어 둔 gemini-2.5-flash-lite는 신규 키에서 404(“no longer available to new users”)였고, 실제 호출로 확인해 현재 세대 Flash-Lite로 바꿨습니다. 분당 한도(429)에 걸리면 기다렸다 다시 부릅니다.
에이전트 모드
왜 검사를 에이전트 여러 개로 쪼갰나요?
왜한 덩어리로 다 하면 ‘무엇을 근거로 그렇게 판단했는지’가 섞입니다. 부서를 나누면 각자 할 수 있는 일(skill)과 등급이 공개됩니다. 주고받은 요청·결과도 기록에 남습니다.
어떻게총괄(오케스트레이터) 아래 사전 검사·색·종이·가이드·교정·보고서·원본 수정·안전 관문 9개가 각자 포트에서 돕니다. 주고받는 것은 정해진 계약(A2A)뿐입니다. 에이전트는 서로를 부를 때 자기 이름이 든 경로를 붙여순환 호출과 홉 수를 막고, 모든 요청·결과는 공통 로그에 남습니다(입력 본문은 남기지 않습니다).
결과같은 검사를 ‘바로 검사’와 ‘에이전트 검사’ 두 방식으로 할 수 있습니다. 화면은 같습니다. 인쇄 검수에서 ‘에이전트 검사’를 고르면 바로 아래에서 의뢰별 구간 막대(워터폴)를 볼 수 있습니다. 누가 언제 몇 ms 걸렸는지 나옵니다.
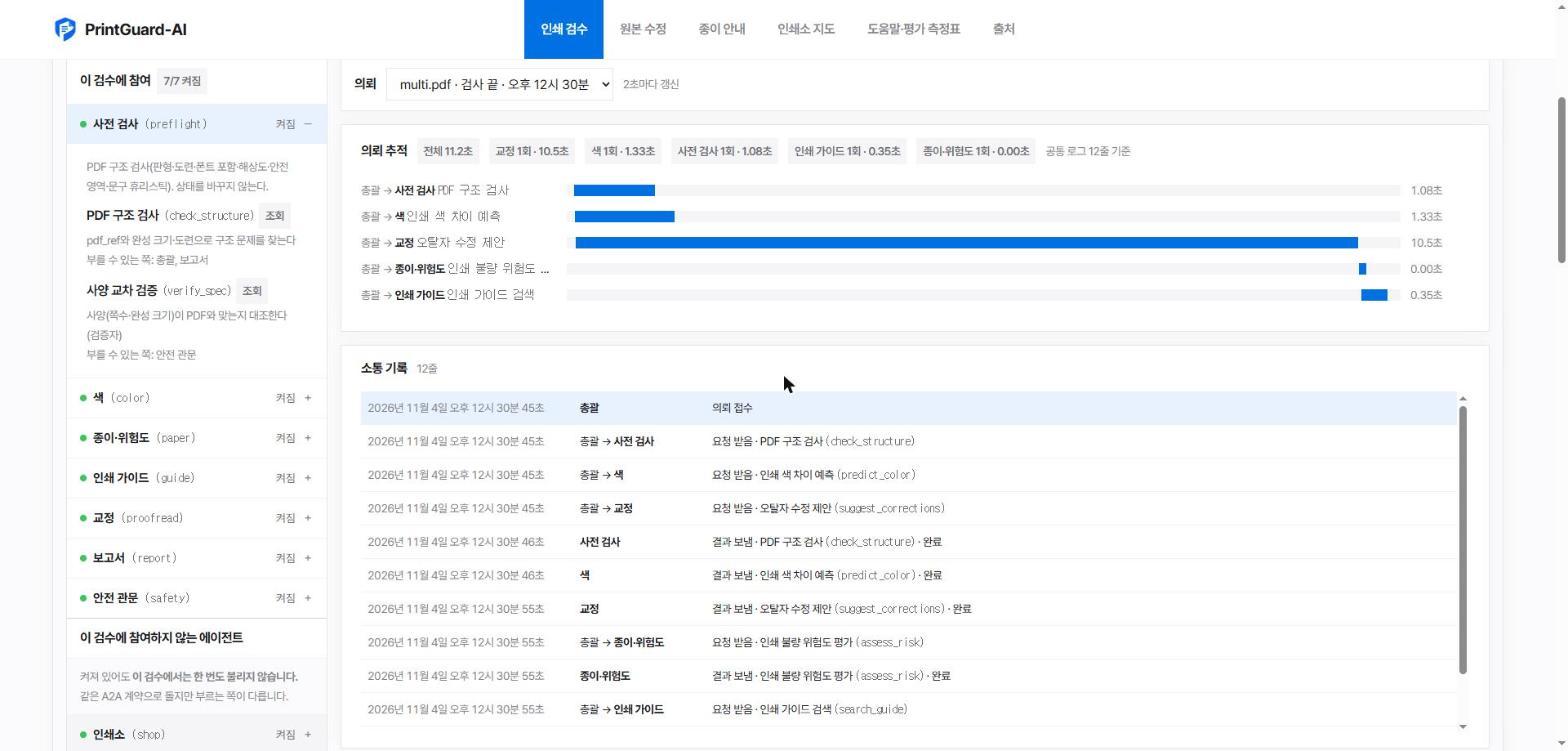
결과켜져 있는 에이전트가 모두 이 검수에 참여하는 것은 아닙니다. 원본 수정(designcraft)은 원본 수정 탭이 씁니다. 같은 A2A 계약으로 돌지만 PDF 검수 흐름에서는 한 번도 불리지 않아서, 목록을 ‘이 검수에 참여’와 ‘이 검수에 참여하지 않는 에이전트’로 갈라 두었습니다. 섞어 두면 ‘켜짐’만 보고 이 검사가 쓰는 줄로 읽힙니다.
검수에서 찾은 오탈자를 원본 파일에 자동으로 반영할 수 있나요?
왜검수는 PDF로 하는데 PDF는 고칠 수 없습니다. 인디자인이 만든 PDF에서 글자를 집어 바꾸는 길이 없어서, 결국 사람이 원본을 열고 하나씩 다시 찾아 고쳐야 했습니다. 항목이 수십 개면 그 과정에서 빠뜨립니다.
어떻게검수 결과를 ‘쪽 | 원래 내용 | 수정할 내용’ 줄로 복사해 원본 수정 화면에 붙여 넣고 편집 파일(IDML)을 올리면, DesignCraft를 MCP로 불러 그 글자를 찾아 바꾸고 PDF로 다시 내보냅니다. 교정 한 건마다 다시 찾습니다 — 한글은 글자당 3바이트라 앞을 고치면 뒤 위치가 전부 밀리는데, 다시 찾으면 밀린 자리가 따라옵니다.
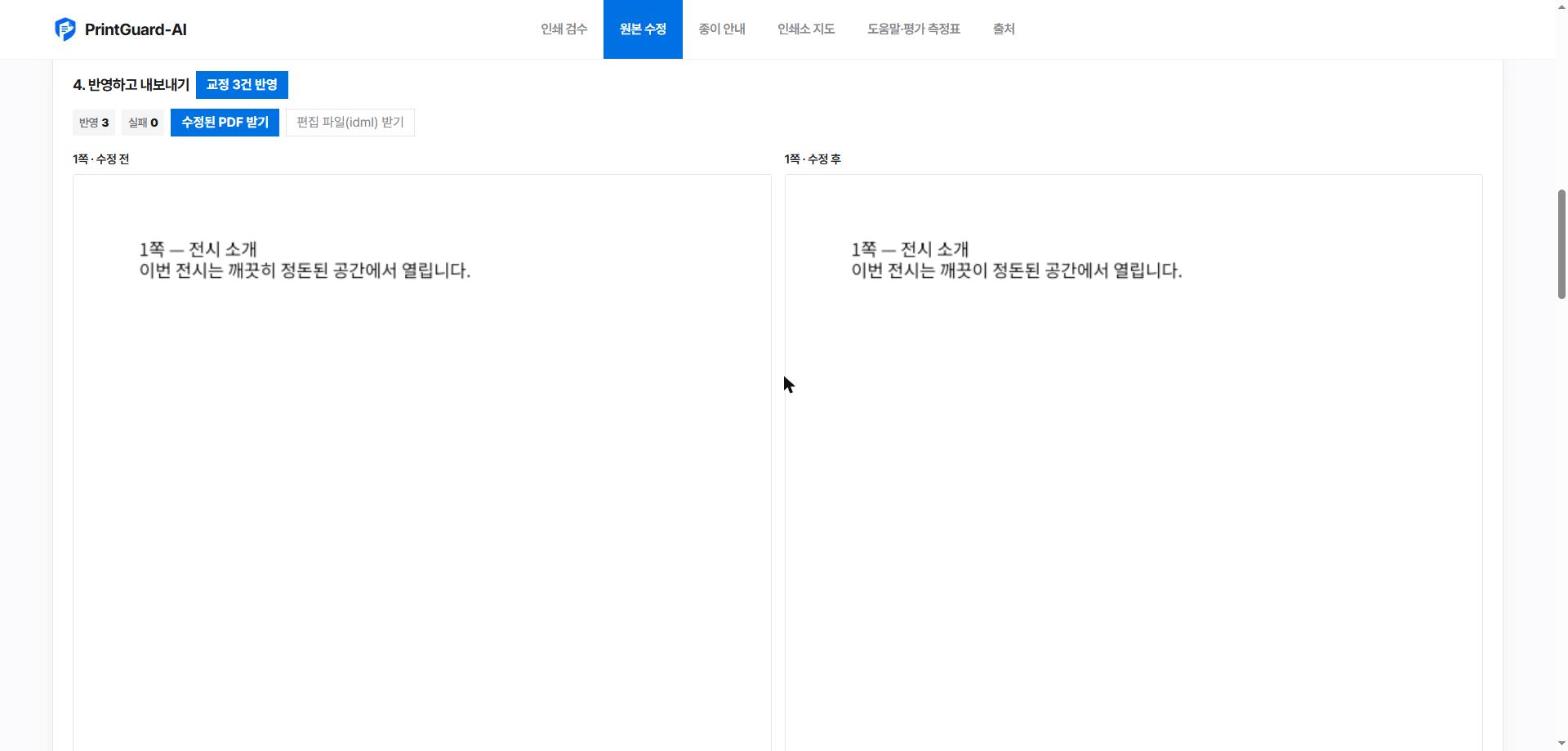
결과바뀐 쪽의 수정 전·후를 나란히 보여 주고, 어떤 항목이 반영됐고 무엇이 왜 실패했는지 줄마다 적습니다. 고친 뒤에는 원본 검사를 한 번 더 돌립니다. 한글을 라틴 글꼴 자리에 넣으면 글자가 없고(글리프), 글이 길어지면 넘칩니다.
designcraft-cli가 있어야 합니다. 원본 수정 화면 맨 위에 설치 명령이 복사 버튼과 함께 있습니다.결과파일 하나보다 폴더째 올리는 편이 좋습니다. IDML은 사진을 링크로만 들고 있어서, 파일 하나만 올리면 인쇄용 사진이 따라오지 않습니다(화면에 보이는 그림은 IDML이 품은 저해상 미리보기라 인쇄에는 못 씁니다). InDesign에서 파일 → 패키지로 만든 폴더를 통째로 올리면 옆의 Links 사진과 Document fonts 글꼴까지 같이 올라가 그대로 열립니다. 글자 교정만 하고 고친 IDML만 받을 거면 파일 하나로도 됩니다.
파일을 쓰는 것처럼 되돌리기 어려운 행동은 어떻게 막나요?
왜상태를 바꾸는 행동은 모델이 잘못 판단하면 되돌리기 어렵습니다. 그래서 판단하는 쪽과 실행을 허가하는 쪽을 갈라 두었습니다.
어떻게행동마다 등급을 둡니다 — 조회는 관문 없음, A는 바로 실행, B는 다른 에이전트가 교차 검증해야 실행, C는 사람이 승인해야 실행.
어떻게등급은 요청이 아니라 행동 주인의 공개 카드에서 읽습니다. 요청에 ‘등급 A’라고 적어 보내도 무시합니다.
어떻게그 밖의 거절 조건도 있습니다. 하루 누적 한도를 넘으면 거절하고, 무엇이든 확인되지 않으면 역시 거절합니다(fail-closed).
결과지금 이 앱에서 상태를 바꾸는 행동은 검수 보고서 파일 쓰기(A)와 원본 수정 반영(A) 둘입니다. 그 보고서의 ΔE도 색 에이전트가 다시 계산해 일치할 때만 그대로 적힙니다. B·C 동작(교차 검증, 사람 승인, 승인 기한 만료, 하루 한도)은 코드와 테스트로 남아 있습니다 — 돈이 오가는 행동을 이 앱에 두지 않았기 때문입니다.
human:<이름>)이며 실제 로그인이 아닙니다. 쓸 일이 생기면 진짜 로그인으로 바꿔야 합니다.내 파일은 어디로 가나
올린 파일이 서버로 가나요? 외부로 나가는 것이 있나요?
결과바로 검사 — 아무 데도 가지 않습니다. PDF 해석·색 변환·검색 모델이 모두 보시는 분의 브라우저 안에서 돕니다. 종이·인쇄소 데이터도 이 앱이 들고 있는 파일이라 받아 갈 것이 없습니다.
결과에이전트 검사 — 만든 사람의 PC로 갑니다. 에이전트는 서버를 빌리지 않고 개발자 PC에서 돕니다(127.0.0.1에서만 듣고, 바깥에는 Cloudflare 터널로 창구 하나만 엽니다). 올린 파일은 그 PC의 폴더에 저장되고, 에이전트끼리는 파일 내용 대신 해시(pdf_ref)만 주고받습니다. 서버가 다시 뜨면 의뢰 목록은 지워집니다.
결과원본 수정에 올린 편집 파일도 같은 PC입니다. 폴더째 올려도 그 PC의 작업 폴더에만 풀립니다. DesignCraft는 그 폴더 밖을 읽지도 쓰지도 못하게 가둬 놓고 띄웁니다(--automation-read-root·--write-root). 고친 PDF와 편집 파일도 같은 폴더에 생깁니다. 받아 갈 수 있는 쪽은 그 의뢰를 넣은 본인뿐입니다.
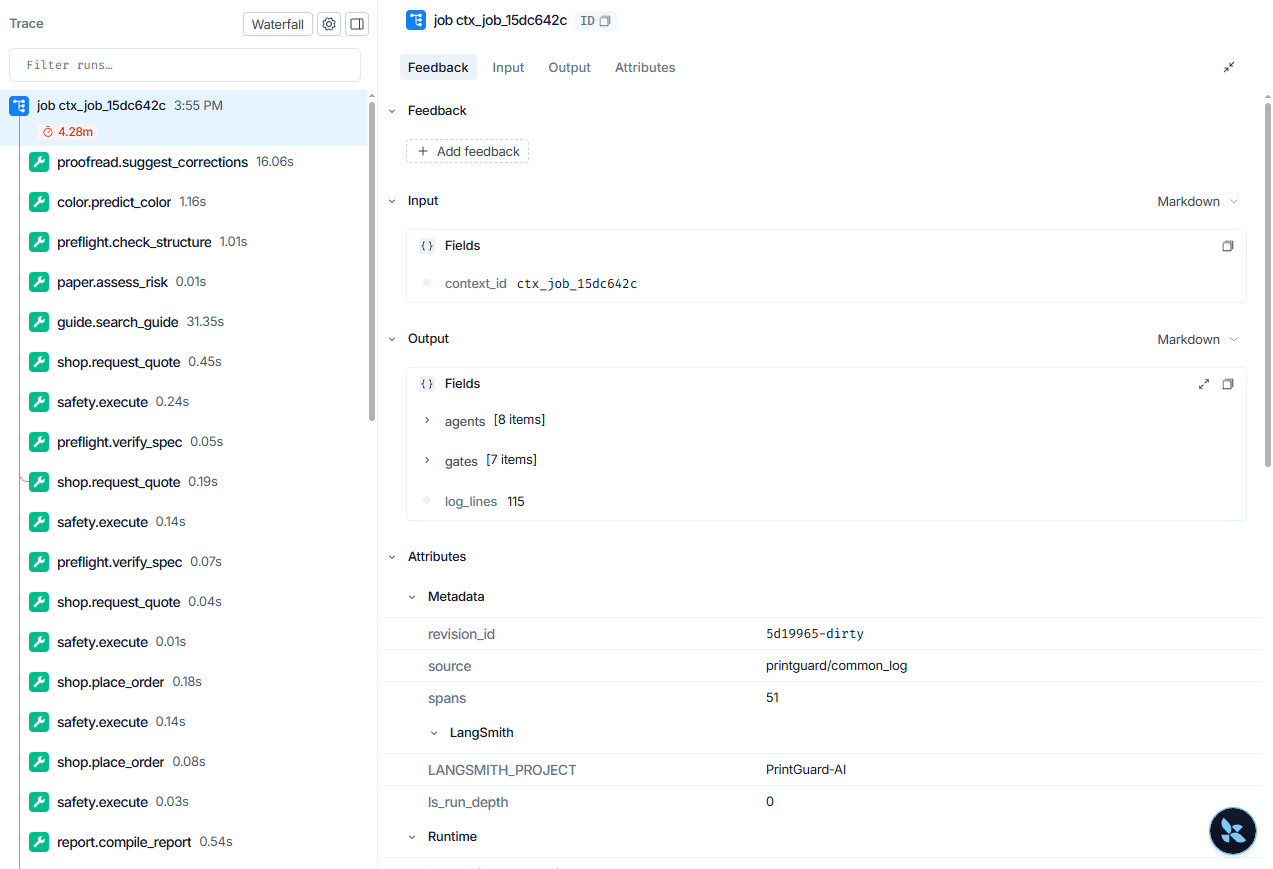
결과선택 기능 두 개만 밖으로 나갑니다 — LLM 교정을 켜면 교정할 본문이 Gemini API로 가고(기본 꺼짐), LangSmith 추적을 켜면 에이전트·소요 시간·관문 결정만 갑니다(본문·입력값은 공통 로그에 애초에 남기지 않아 나갈 것이 없습니다).
로그인을 꼭 해야 하나요? 하면 무엇이 달라지나요?
왜에이전트는 PC 한 대인데 그 주소는 누구에게나 열려 있습니다. 주인을 가리지 않으면 남의 파일 이름과 소통 기록이 그대로 보이고, 남의 질문에 대신 답까지 할 수 있습니다. 그렇다고 쓰려면 먼저 계정부터 만들라고 하는 것도 과합니다 — 한 번 검수해 보려고 온 사람에게는 그 자체가 벽입니다.
어떻게로그인은 선택입니다. 하지 않아도 검수는 전부 됩니다. 대신 화면을 열면 서버가 난수로 만든 익명 토큰을 하나 내주고, 브라우저가 그것을 localStorage에 둡니다. 누구인지는 담기지 않고, 하는 일은 “이 브라우저가 넣은 의뢰만 이 브라우저에 보인다”뿐입니다.
어떻게로그인하면 그때까지 한 것이 계정으로 옮겨 갑니다. 구글이 서명한 ID 토큰에는 계정마다 고유한 번호(sub)가 들어 있습니다. 그 번호에 묶인 토큰을 새로 받고, 들고 있던 익명 토큰을 서버에 한 번 내밀어 그 토큰 몫의 의뢰를 전부 계정으로 옮깁니다. 옮기고 나면 로컬에 있던 익명 토큰은 지웁니다.
결과그래서 로그인 뒤에는 기기가 바뀌어도 같은 계정으로 들어오면 지난 검수가 그대로 보입니다. 로그인 전에는 그 브라우저를 벗어나지 못합니다 — 사이트 데이터를 지우면 함께 사라집니다.
결과받아 두는 것은 구글 계정 번호와 이름·이메일·프로필 사진뿐입니다. 계정 번호도 그대로 쓰지 않고 서버 비밀로 해시해서 씁니다. 의뢰 기록과 로그에 남는 값이라, 새면 계정 번호까지 같이 샙니다. 이름·이메일·사진은 화면 오른쪽 위에 누구로 로그인했는지 보여 주는 데만 쓰고 서버에 저장하지 않습니다. 비밀번호는 지나가지도 않고, 검사에는 아무것도 쓰지 않습니다.
결과아이디·비밀번호를 직접 받지 않는 이유는 간단합니다 — 받으면 보관해야 하고, 보관하는 순간 샐 것이 생깁니다. 구글이 서명한 ID 토큰의 서명·발급자·청중(이 앱의 클라이언트 ID)·기한만 확인합니다. 청중 확인이 핵심입니다. 그것이 없으면 아무 앱에나 로그인해서 받은 토큰을 그대로 들이밀 수 있습니다.
결과로그인한 토큰은 저장하지 않습니다. 새로 고치면 사라지고 구글에 조용히 다시 물어 받습니다 — 잃어도 다시 받으면 그만이라 남길 이유가 없습니다. ‘바로 검사’는 계산이 전부 브라우저 안에서 끝나니 보낼 곳도, 가릴 주인도 없습니다. MCP로 들어올 때는 로그인 창을 띄울 수 없어 미리 발급한 토큰을 씁니다.
crypto.randomUUID()로 스스로 만든 값을 주인 표시로 썼습니다. 서버가 발급하지 않으니 기한도 회수도 없었습니다. 지금 localStorage에 있는 값은 서버가 발급하고 서명한 토큰이고, 기한이 있으며, 로그인하는 순간 지워집니다.화면에 있는 다른 것들
완성 크기와 도련을 왜 손으로 적지 않나요?
왜그 값은 이미 파일 안에 있습니다. 손으로 적게 하면 오타 한 번에 ‘페이지 크기가 설정과 다름’이 모든 쪽에 뜨고, 사람은 파일을 의심합니다. 실제로 틀린 것은 입력 칸입니다.
어떻게파일을 고르는 순간 1쪽의 TrimBox(재단 후 완성 크기)를 읽어 가로·세로를 채웁니다. 도련은 MediaBox와 TrimBox 사이에 남은 폭에서 잽니다. 사방이 다르게 들어간 파일이 있어서 가장 좁은 쪽을 씁니다. 읽은 치수가 목록의 판형과 1mm 안에서 맞으면 그 판형을 골라 둡니다.
결과무엇을 어디서 읽었는지 칸 아래에 그대로 적습니다 — 쪽 수, 치수, 판형 이름, 도련, 읽은 상자 이름까지. 자동으로 채운 값은 어디서 왔는지 보여야 사람이 되돌릴 수 있습니다.
검수 결과를 다른 곳으로 가져갈 수 있나요?
어떻게결과 위의 두 버튼이 서로 다른 글을 만듭니다. 검수 결과 전체는 사람이 읽는 글이라 메일·메신저에 그대로 붙입니다. 교정 목록은 기계가 읽는 줄(쪽 | 원래 내용 | 수정할 내용)이라 원본 수정 화면에 붙여 넣습니다.
결과에이전트 검사에서는 검수 보고서 파일도 만들 수 있습니다. 상태를 바꾸는 일(A 등급)이라 안전 관문을 거치고, 보고서에 적히는 ΔE는 색 에이전트가 다시 계산해 일치할 때만 들어갑니다.
다른 도구(클로드·커서)에서 이 검수를 부를 수 있나요?
왜검수를 화면에서만 쓸 수 있으면, 원고를 고치는 자리에서 쓰려고 할 때마다 사람이 파일을 날라야 합니다.
어떻게같은 에이전트를 MCP 서버로도 엽니다(pg_agents.mcp_server). 같은 PC에서 켜면 띄운 사람이 주인이라 설정만 하면 바로 돌고, 다른 PC에서 붙일 때는 python -m pg_agents.mktoken으로 받은 토큰이 있어야 합니다.
결과주소로 열면 두 가지가 달라집니다 — check_pdf(path=…)는 막히고(그 path는 서버 PC의 파일이라, 멀리서 남의 PC 파일을 고르는 길이 됩니다) 파일을 올려야 하며, 보고서 쓰기는 쓰기 권한이 있는 토큰만 통합니다.
인쇄소 지도·종이 안내·출처 탭은 무엇인가요?
결과인쇄소 지도는 공공데이터의 인허가 자료로 만듭니다. 지도에서 찾을 수 없는 자리(좌표를 도로 단위로만 추정한 것)와 폐업으로 확인된 곳은 빼고 보여 줍니다. 추정 좌표를 그대로 찍으면 거기 없는 업체를 있다고 가리키게 됩니다.
결과종이 안내는 검수에서 고르는 종이 489종을 같은 데이터로 펼쳐 놓은 화면입니다. 등급별 프로파일과 잉크량 한도를 함께 봅니다.
결과출처는 이 앱이 쓴 자료를 전부 적은 목록입니다 — 데이터·ICC 프로파일·모델·라이브러리·근거 문헌, 직접 만든 것까지. 링크가 없는 항목은 유료 규격이거나 원문이 사라진 것이고, 그 사실을 그대로 적었습니다.